Jev:类型化决策模型 — 社区真实评价综述
Jev:类型化决策模型 — 社区真实评价综述
2026-09-23 | TypeSafe AI 发布 Jev "System One Model"
一句话定位
Jev 不是 LLM。它不生成文本,只返回类型化决策(Choice / Score / Noul)+ 校准概率。社区评价两极分化:实用派说"快省钱好用",怀疑派说"营销大于创新"。
模型概述
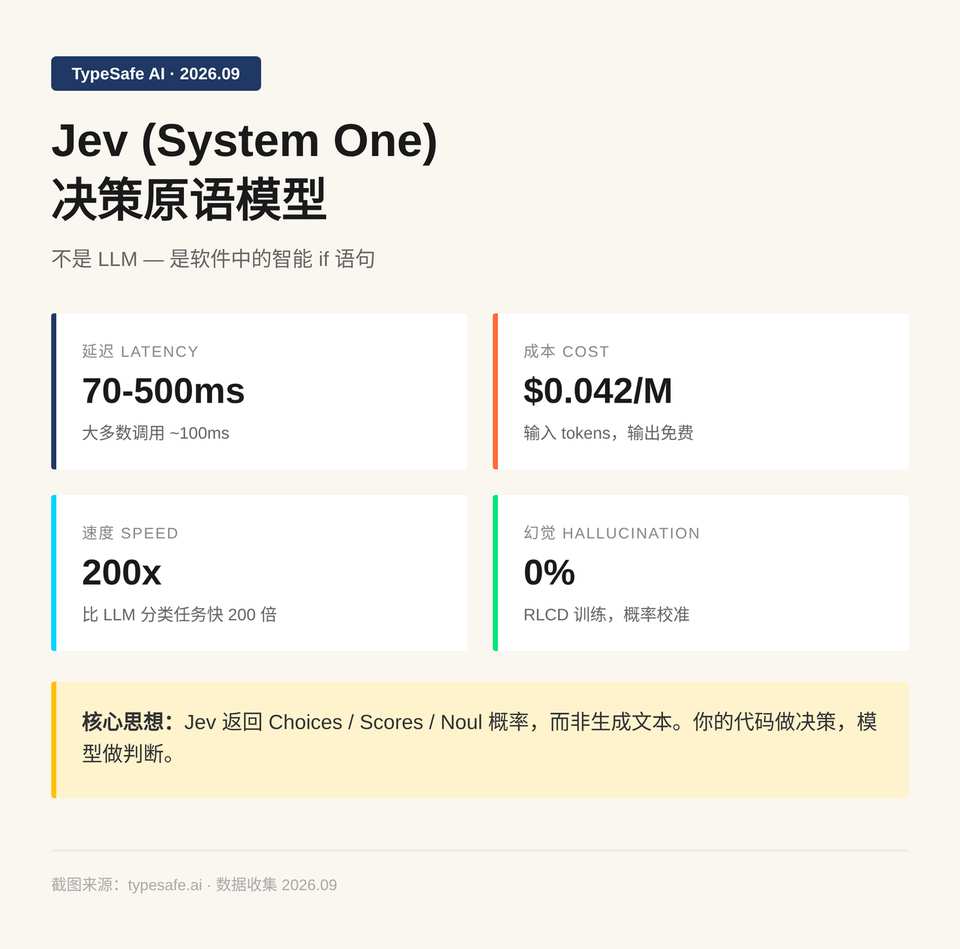
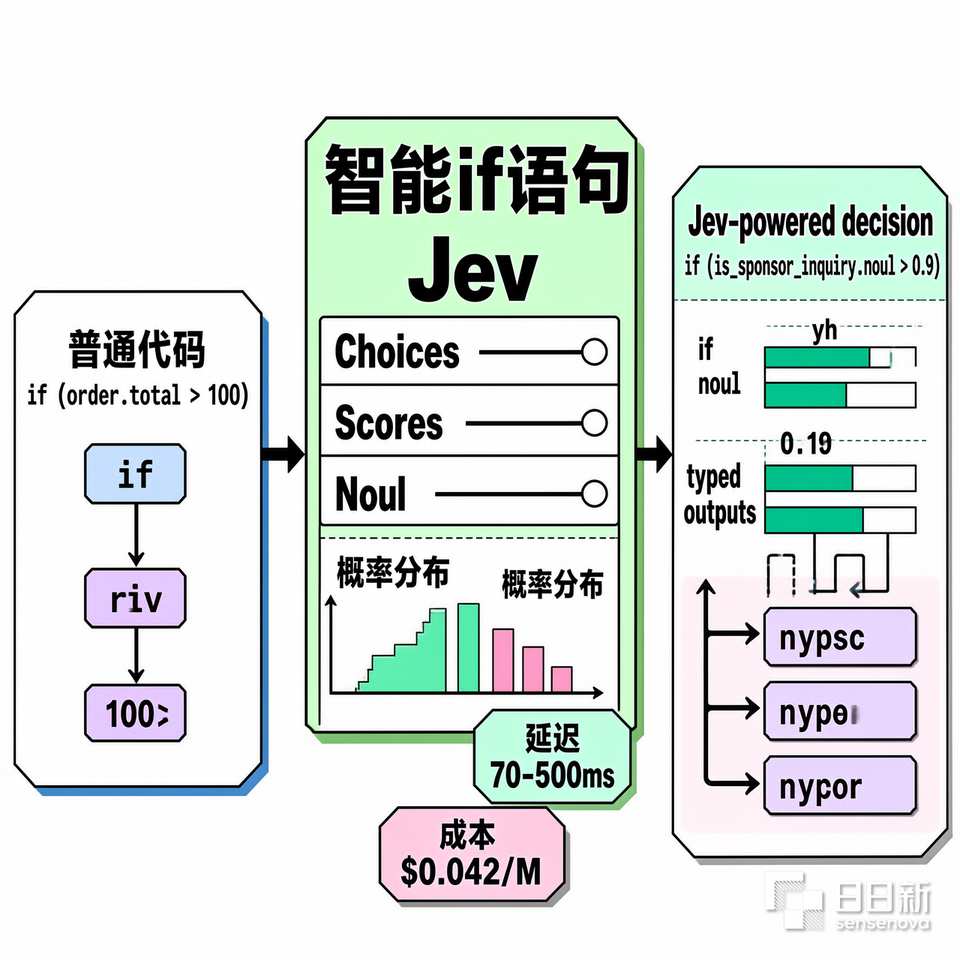
Jev 是 TypeSafe AI 发布的 System One Model — 不是一个 LLM,而是一个决策原语模型。它返回 Choices、Scores 和 Noul (yes/no) 概率,而非生成文本。
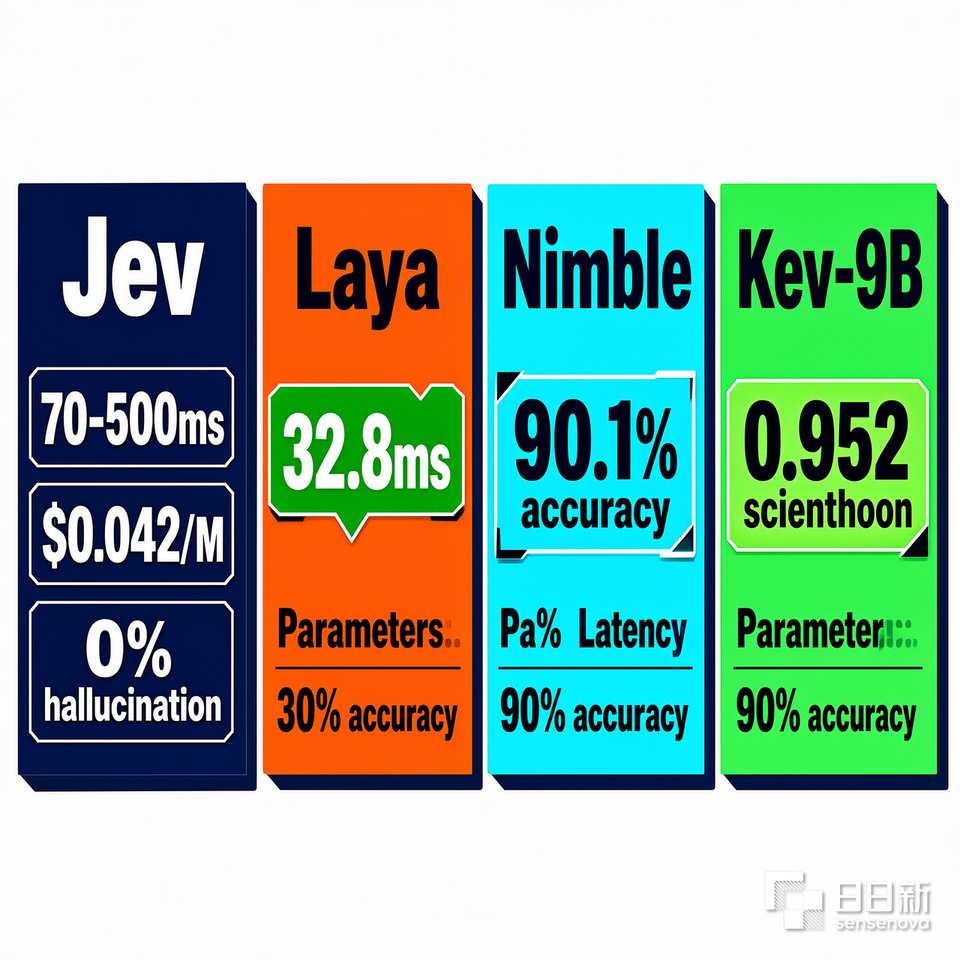
核心特性: 70-500ms 延迟, $0.042/M input tokens (输出免费), 0% 幻觉 (声称), RLCD 训练, 250K tokens/sec 限流。
使用方式
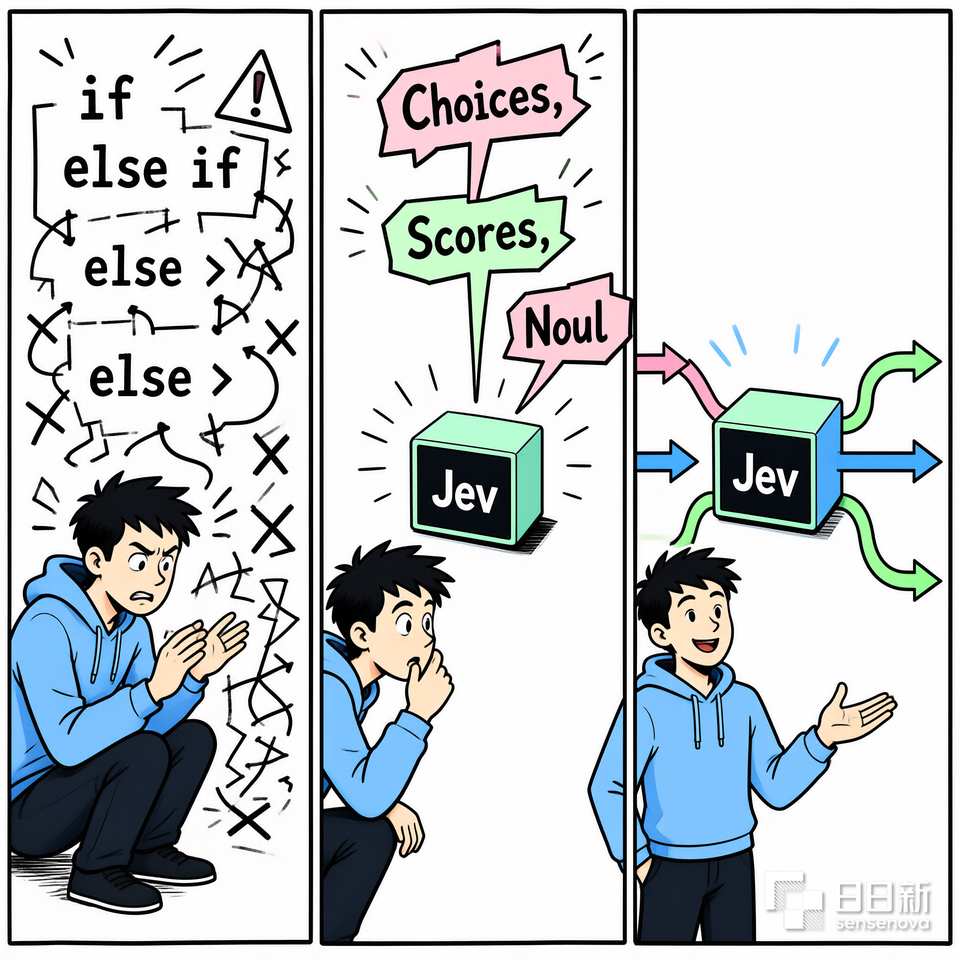
Jev 最简单的描述:它是软件中的智能 if 语句。不用写 if (order.total > 100),而是调用 Jev 获取概率分数,基于输出做决策。
API: POST https://api.typesafe.ai/v1/systemone — 输入: 文本, 输出: Choices/Scores/Noul。
最佳架构
Jev 负责路由 → LLM 负责推理 → Code 负责执行
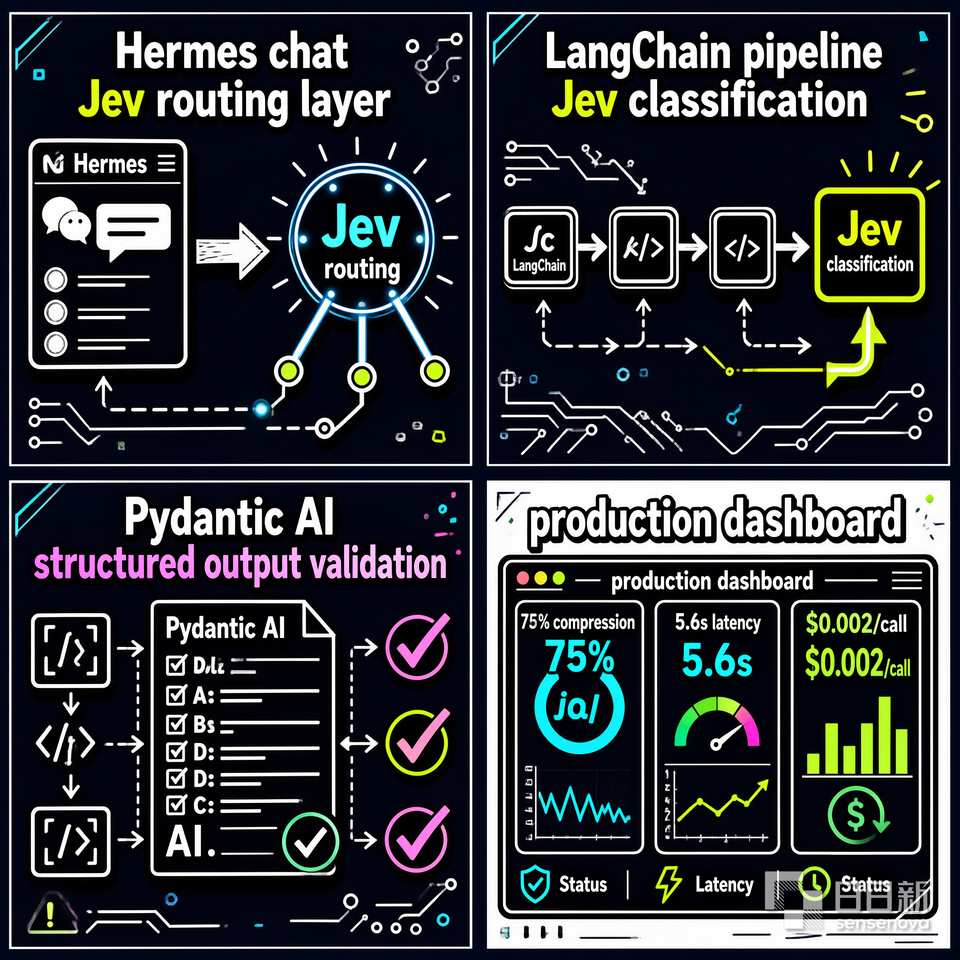
| Integration | Performance |
|---|---|
| Hermes (75% compression) | 5.6s latency, $0.002/call |
| LangChain harness | Classification routing |
| Pydantic AI | Structured output validation |
正面评价
1. 速度与成本震撼
"Jev is a game changer for routing and classification tasks. The speed is insane — 70-500ms with 0% hallucination." — r/ArtificialInteligence 用户
译文: Jev在路由和分类任务上是游戏规则改变者。速度惊人——70-500ms延迟,0%幻觉。这正是我们生产系统需要的。
"Super fast/cheap decision engine with Luna-level intelligence." — r/singularity 用户 manubfr
译文: 超快超便宜的决策引擎,智力水平与Luna相当。性价比惊人。
2. 性能碾压 LLM
"Finally, a model that does one thing well. 200x faster than LLMs for classification." — HN 用户
译文: 终于有一个模型能把一件事做好。分类任务比LLM快200倍。
"Up to 200x faster inference and 400x lower cost than comparable LLMs on classification tasks." — LangChain 博客
译文: 分类任务上的推理速度比可比LLM快200倍,成本低400倍。
3. 实际应用
"Jev turns text into typed choices, scores, and probabilities. Most calls complete in about 100ms." — Flavio Copes, dev.to
译文: Jev将文本转换为类型化的选择、分数和概率。大多数调用在100ms内完成。
"I used to use GLiNER back in the day, that model is so impressive. Jev is in the same league for classification tasks." — r/LocalLLaMA 用户
译文: 以前用GLiNER,那个模型令人印象深刻。Jev在分类任务上属于同一级别。
4. 代码质量 & 对齐性
"Jev works well on code quality." — r/singularity 用户
译文: Jev在代码质量方面表现良好。
"Tested on 4 public benchmarks, outperformed every other solution significantly at grading harmful prompts/generations." — r/singularity 用户 manubfr
译文: 在4个公共基准测试中评估有害提示/生成,表现显著优于其他所有方案。
负面评价与局限
1. 只是分类器
"Just a classifier, nothing special. Marketing hype over innovation." — r/LLM 用户
译文: 只是个分类器,没什么特别的。营销炒作大于创新。
"Not an LLM, doesn't write code or generate text. Limited use case." — r/ClaudeCode 用户
译文: 不是LLM,不写代码不生成文本。用途有限。
2. 数据质疑
"193.6x faster, 444.6x cheaper — but those are the best-case numbers." — HN 用户
译文: 193.6倍快、444.6倍便宜——但这些是TypeSafe自己评估中的最佳情况数据。
"Laya (421M) achieves comparable speed, Kev-9B beats Jev on scienthoon tickets (0.952 vs 0.897)." — r/LocalLLaMA 用户
译文: Laya (421M) 达到可比速度,Kev-9B 在scienthoon测试中击败Jev。
3. 炒作质疑
"Why so much hype? Muse is the most downloaded app on the app store." — r/singularity 用户 sweatierorc
译文: 为什么这么炒作?Muse是App Store下载量最高的应用。
4. 缓存破坏风险
"Cache-breaking risk when integrating with Hermes." — Teknium / Hermes 社区
译文: 与Hermes集成时存在缓存破坏风险。
5. 不适用场景
- ✗ 文本生成: Jev 不能写回复、生成代码或总结文档
- ✗ 精确算术: 不擅长数学计算
- ✗ 图像/音频输入: 仅接受文本,需要先转换为文本
- ✗ 推理任务: 无 System 2 推理能力,需要 LLM 配合
综合评价与结论
适用场景
✓ 路由决策: Jev 负责路由/Guard → LLM 负责推理 → Code 负责执行
✓ 内容审核: 快速分类有害内容,低至 $0.0000126/次
✓ 意图识别: 多标签分类,概率输出支持置信度阈值
✓ 事件过滤: 数据管道中用条件逻辑替代硬编码 if-else
社区共识
- 正面社区: Jev 是"智能 if 语句",最佳实践是并行运行 Jev → 标注对错 → 调整阈值 → 自动化低风险路径
- 负面社区: Jev 只是个分类器,营销大于创新
- 中立观点: Jev 在特定场景确实有性能优势,但应被视为 LLM 的补充
结论
Jev 是有趣的"决策原语"模型,在分类/路由/打分场景下有显著的性能和成本优势(70-500ms, $0.042/M tokens, 0% 幻觉声称)。然而它不是通用模型——不能生成文本、写代码或推理。社区分化:实用主义者认为是 game-changer,怀疑论者认为是营销话术。实际价值取决于应用场景。
数据来源:Reddit r/ArtificialInteligence, r/singularity, r/LLM, r/ClaudeCode, HN, DataCamp, LangChain, explainx.ai, Flowtivity, ChatMaxima