Modal 每月白送的 30 刀,到底能玩出什么花样?
Modal 每月白送的 30 刀,到底能玩出什么花样?
一、先说清:这不是 30 刀现金
Modal 送的这 $30,不是打到账户的余额,而是每月重置的算力额度(compute credit)。它只能抵你在 Modal 上跑 GPU/CPU 的账单,不能提现、不滚存、月底清空。
但别小看它。Modal 按秒计费,无最低消费,不用不花钱,缩到零就归零。那 $30 不是"买 30 块钱的云",而是"买一大段实打实的 GPU 时长"——多少取决于选哪张卡:
| GPU | 显存 | 每小时单价 | $30 能跑多久 |
|---|---|---|---|
| T4 | 16G | $0.59 | 约 50 小时 |
| L4 | 24G | $0.80 | 约 37 小时 |
| A10 | 24G | $1.10 | 约 27 小时 |
| L40S | 48G | $1.95 | 约 15 小时 |
| A100-80G | 80G | $2.50 | 约 12 小时 |
| H100 | 80G | $3.95 | 约 7.6 小时 |
| H200 | 141G | $4.54 | 约 6.6 小时 |
| B200 | 192G | $6.25 | 约 4.8 小时 |
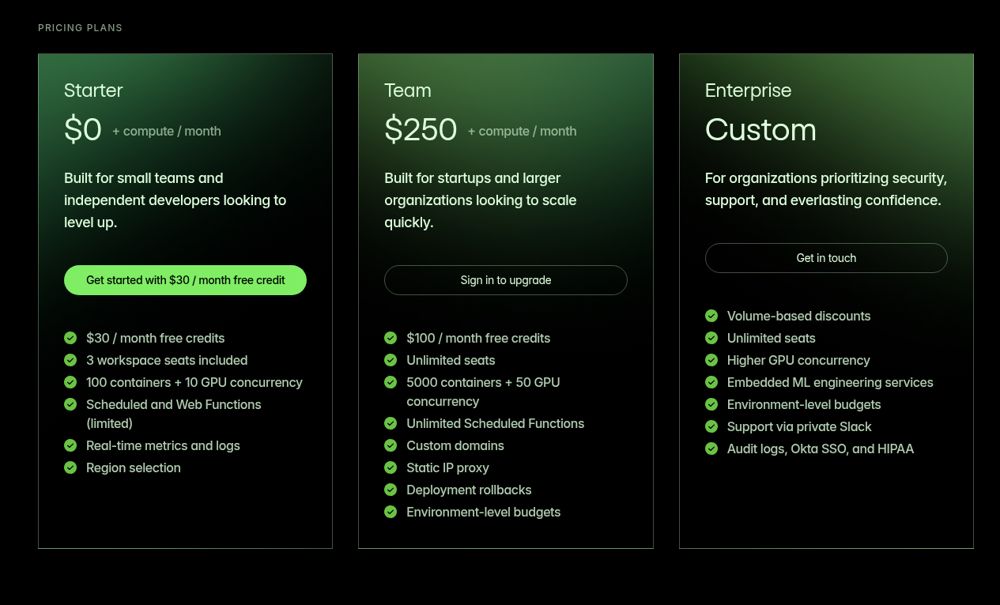
截图来源:modal.com/pricing(官方定价页,含 GPU 按秒单价与 Starter $30/月免费额度)
一句话逻辑:同样的 $30,选便宜的卡跑轻量模型 = 海量产出;选贵卡跑旗舰模型 = 少量但高质量。下面分场景拆。
二、它怎么算钱:搞懂计费,不然白送也浪费
很多人第一次收到 Modal 账单会吓一跳——明明只跑了 2 秒的函数,却扣了几百秒的钱。根因在容器生命周期:
计费起点:容器拉起、GPU 挂载那一刻就开始算,连镜像装依赖(pip_install)的时间都算 GPU 钱。
计费终点:容器被完全销毁才停。
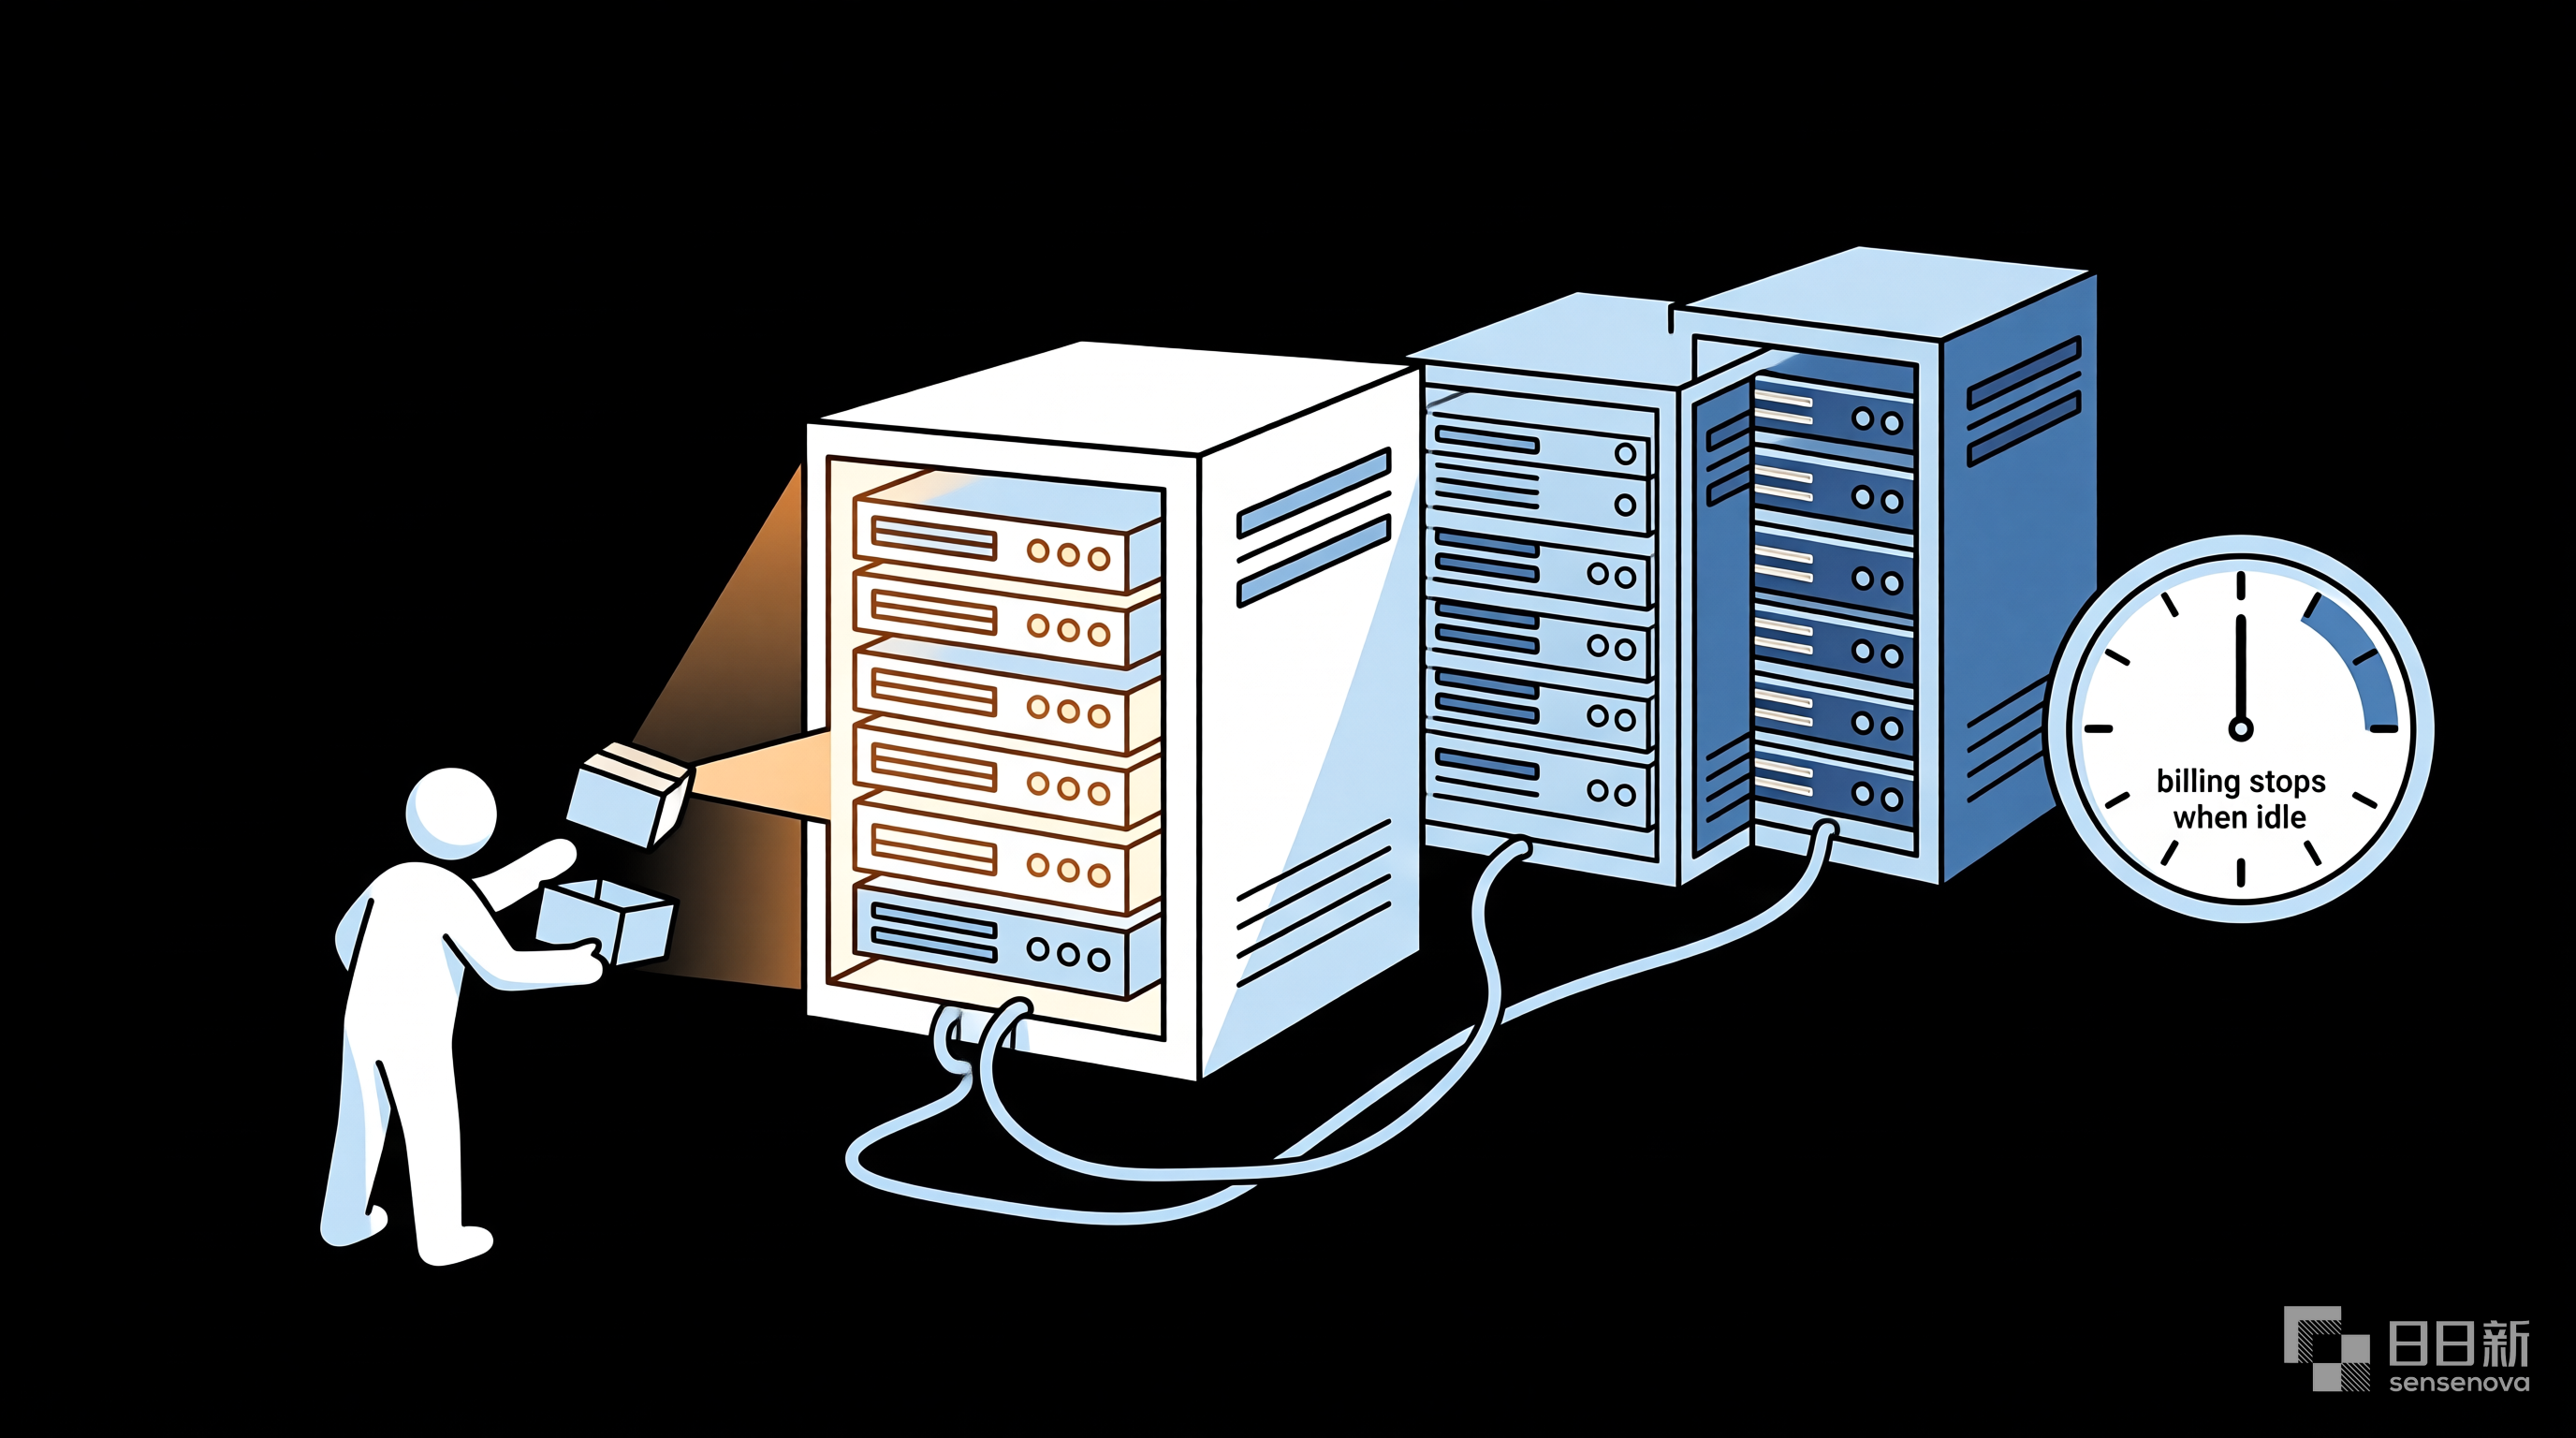
最大坑——空闲超时:函数跑完之后容器不会立刻死,默认热留一段时间等下个请求(避免冷启动),这段空闲等待照样按秒计费。旧默认 300 秒(5 分钟),现在 @function 上 scaledown_window 默认 60 秒——不设就按默认来。
例子:2 秒的函数 + 默认 300 秒空闲 = 被扣 302 秒 GPU 钱,而不是 2 秒。
怎么不白扣(对白嫖党尤其重要):
- 设 container_idle_timeout=0 或短窗口(20–60s),函数结束立刻缩;
- 所有任务一次性批量投进同一容器(间隔小于窗口就共享热容器,不重复扣启动费);
- 用预构建镜像(Image.from_registry()),别每次现装依赖;
- 别设 min_containers,让自动缩 0;
- 绑定卡后立刻设 spending limit = $30:超了自动暂停,绝不意外扣钱。
把上百个生成任务排在同一个热容器生命周期内批量跑,就是 Modal 上"缓存命中"最贴切的等价操作——不是真有缓存抵扣,而是不反复冷启。
三、玩法一:跑开源文本模型(LLM)
Modal 官方就鼓励你用免费额度部署开源 LLM。现成教程有 vLLM 部署(明确写"整个教程完全免费")和 Ollama 示例。
用 vLLM 实测吞吐换算,$30 在各开源旗舰模型上能跑出多少 token(可持续吞吐,非极限值):
| 模型 | 跑哪张卡 | 实测吞吐 | $30 换来的输出 token |
|---|---|---|---|
| 8B 级(Llama-3.3-8B / DS-R1-Distill-Qwen-7B) | 1× A10 | 约 800 tok/s | 约 7800 万 |
| 30–32B(Qwen3-30B/32B) | 1× L40S | 约 200 tok/s | 约 1100 万 |
| 70B 稠密(Llama-3.3-70B) | 1× A100-80G | 约 190 tok/s | 约 820 万 |
| 70B 蒸馏(DS-R1-Distill-Llama-70B) | 1× A100-80G | 约 300 tok/s | 约 1300 万 |
| 约 110B(GLM-4.5-Air / gpt-oss-120B) | 2× A100-80G | 约 200 tok/s | 约 430 万 |
| 235B MoE(Qwen3-235B) | 4× A100-80G | 约 400 tok/s | 约 430 万 |
加上 90% 缓存命中(输入 token 的 KV cache 复用,典型 10:1 负载下输入只增 10–20% 成本),同样的 $30 还能额外吃下约 10 倍于输出数的输入 token。
实话:小模型白嫖极香(8B 级一个月近 8000 万 token);70B 旗舰只是够用(800–1300 万,约合 API 上 $5–15 价值);超大 MoE 在免费档不划算(DeepSeek-V3 / Kimi-K2 卡时长上限或被 10 卡并发限制挡掉)。而且按 token 成本算,32B 在 Modal 上约 $2.7/百万输出,而 DeepInfra 同模型 API 才 $0.4/百万——自托管反而贵。免费额度的意义是"$0 试跑 / 隐私 / 定制",不是"比 API 便宜"。
四、玩法二:跑绘画模型(最值)
图像生成没有 token 概念,单位是"张/秒"。取公开可持续吞吐,1024×1024 单图:
| 模型 | 卡 | 每图耗时 | $30 可出图数 |
|---|---|---|---|
| SD1.5(20 步) | 1× A10 | 约 1s | 约 9.8 万张 |
| SDXL(fp16, 30 步) | 1× A10 | 约 4–6s | 约 1.8–2.7 万张 |
| Flux.1-Schnell(4 步蒸馏) | 1× A10 | 约 2–4s | 约 2.7–5.4 万张 |
| Flux.1-Dev(FP8) | 1× A10 | 约 9s | 约 1.1 万张 |
| Flux.1-Dev(BF16) | 1× L40S | 约 7–8s | 约 1.4 万张 |
| Flux.1-Dev(BF16) | 1× A100-80G | 约 5–7s | 约 1.5–2.1 万张 |
官方 Flux 示例直接 modal deploy 就能有个免费画图 API。
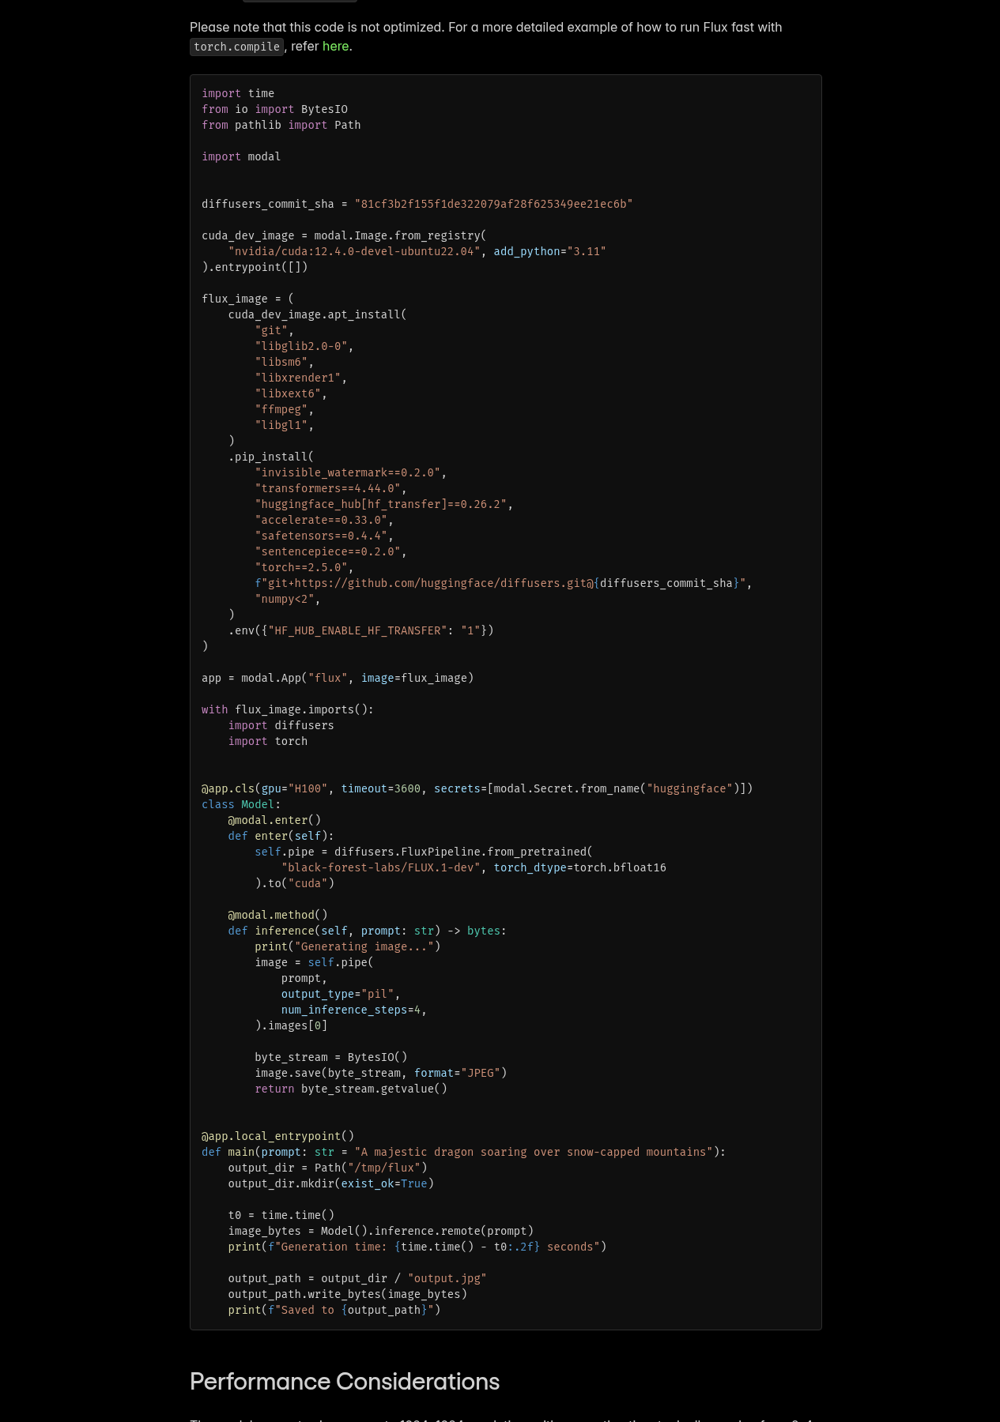
截图来源:modal.com/blog/how-to-run-flux1-dev-on-modal(官方博客,含 H100 示例代码)
官方示例里,跑 Flux.1-dev 只要几行 Python(核心就 @app.cls(gpu="H100") 这一句指定卡型):
import time
from io import BytesIO
from pathlib import Path
import modal

app = modal.App("flux", image=flux_image)

@app.cls(gpu="H100", timeout=3600, secrets=[modal.Secret.from_name("huggingface")])
class Model:
    @modal.enter()
    def enter(self):
        self.pipe = diffusers.FluxPipeline.from_pretrained(
            "black-forest-labs/FLUX.1-dev", torch_dtype=torch.bfloat16
        ).to("cuda")

    @modal.method()
    def inference(self, prompt: str) -> bytes:
        image = self.pipe(prompt, output_type="pil", num_inference_steps=4).images[0]
        return image_bytes
完整脚本见 modal.com/blog/how-to-run-flux1-dev-on-modal。
绘画白嫖收益比文本还猛:SD1.5 在 A10 上月近 10 万张,Flux.1-Dev 也有 1 万+ 张。单图成本 $0.0003–0.001,比任何绘画 API(Midjourney 约 $0.01–0.04/张)便宜 3–100 倍。性价比冠军是 SDXL/Flux 在 A10 上——Flux.1-Dev 是质量/成本甜点(要"真重绘不贴滤镜"质感就走这条),L40S 上约 $0.02/张,一个月 1.4 万张够发几百篇带配图博客。注意:别用 H100 跑图(纯浪费免费额度);保持容器热启才能吃满额度。
五、玩法三:跑视频模型(最肉)
视频最吃资源,单位"秒视频/小时 GPU"。以刚开源的 MiniMax H3(33B 全模态,生成视频+原生音频)为例:官方推荐 4 卡部署(--num-gpus 4 --ulysses-degree 4),而免费档限 10 GPU 并发——H3 占 40% 额度,没法多副本并行。
H3 在 4×A100 上生成一条 5s 视频约 5–8 分钟(同量级视频模型实测参考)。$30 能出:
| 配置 | 4 卡合计单价 | 可用时长 | 每条 5s 耗时 | $30 出图数 | 合计秒数 |
|---|---|---|---|---|---|
| H3 @ 4×A100 | $10.0/时 | 3.0 小时 | 约 6 分钟 | 约 30 条 | 约 150 秒 |
| H3 @ 4×H100 | 约 $15.8/时 | 1.9 小时 | 约 4 分钟 | 约 28 条 | 约 140 秒 |
结论:$30 跑 H3 约能出 140–150 秒视频(约 28–30 条 5s 片段)。
对比更轻的开源视频模型,H3 不是最划算的——Wan2.1-1.3B(480p)单卡 A10 上 $30 能出约 1800 秒,L40S 上约 3000 秒。H3 的价值在质量/多模态(图生视频+参考+原生音频),不是省钱。
六、玩法四:当免费 GPU CI / 实验沙盒
不只跑模型,免费档还能当"云上 GPU 工作站":
- Borda/affordable-GPU-CI:用 Modal serverless GPU 跑 GPU 测试,免费档覆盖一切,L4 上单次约 $0.01–0.02,一月能跑 1000+ 次;
- modal-projects/modal-auto-research-skills:官方 skill 集,教 agent 按需开 GPU、跑完即销、并行多卡,零空闲零浪费;
- adam-s/goldseam:自建 GPU 服务,scaledown_window=15min 后自动缩 0,billing 归零;
- 没本地 GPU 的人:调试 CUDA 代码、跑小规模实验、训练微调小模型,免费档 $5(无卡)够调试,$30(绑卡)覆盖大多小实验。
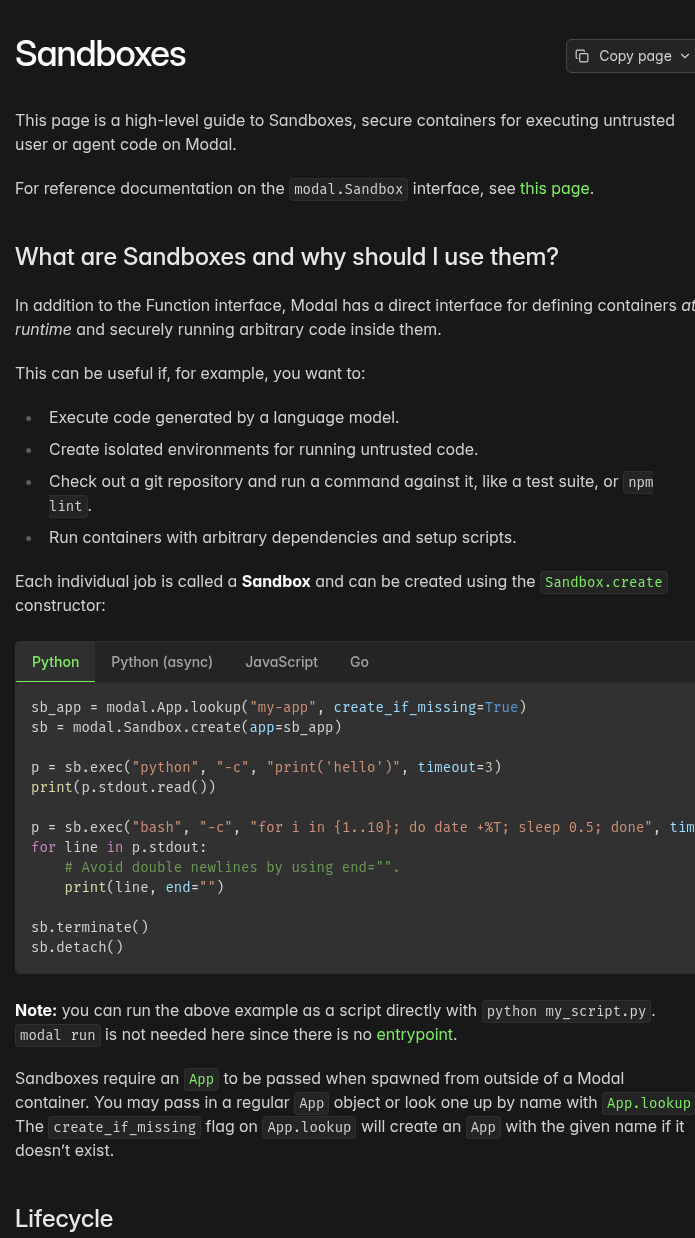
截图来源:modal.com/docs/guide/sandboxes(官方文档,Sandboxes 定义与示例)
官方文档里的 Sandbox 示例(在运行时拉起一个容器、执行任意命令):
import modal

app = modal.App.lookup("my-app", create_if_missing=True)

sb = modal.Sandbox.create("echo hello", app=app)
sb.wait()
print(sb.stdout.read())
用它跑 CI、跑 lint、跑模型生成的代码都行,按秒计费、跑完即销。
七、玩家的共识打法
翻了一圈国内外教程和开源项目,白嫖党基本一致这么做:
- 绑卡后立刻设 spending limit = $30:超了自动暂停,绝不意外扣钱;
- 用 Volume 缓存模型权重:别每次冷启重下几十 GB;
- scaledown_window 控制空闲计费:连续任务排同一容器生命周期内,别反复冷启;
- 选便宜够用的卡:A10/L4 跑图和小模型最划算,别一上来 H100;
- 批量投喂:一次调用喂多张图/多条任务,把启动开销摊薄;
- 分 workspace 隔离实验:避免一个失控实验拉起 10 张 B200。
Yulivu/debuffer-skills 的 serverless-modal 还给了完整的免费预算换算表和 GPU fallback 写法(gpu=["H100","A100-80GB","L40S"] 自动尝试)。
八、哪些事免费档干不了
实话实说,边界要清楚:
- 超大 MoE 语言模型(DeepSeek-V3 671B、Kimi-K2 1T):要么卡时长上限,要么被 10 卡并发限制挡掉,免费档跑不了几分钟;
- 常驻 24/7 服务:缩到零后每次冷启有延迟,不如 reserved GPU 便宜;
- 长训练(超过 4 小时):vast.ai 等按小时更便宜;
- 高并发生产:10 GPU 并发 + 1 天日志 + 无自定义域名,正式产品不够。
免费档最适合:突发式(bursty)任务、批量推理、短微调、实验原型。长期常驻或大训练,去 vast.ai / reserved 实例更划算。
九、落到你手上的建议
如果你和我一样是"想速成做项目、不想被云账单吓到"的人,Modal 免费档是最低门槛的 GPU 入口:
没本地 GPU?绑个卡,设 $30 上限,安全试;
要画图配博客?抄官方 Flux 示例,modal deploy 一个免费画图 API,一个月 1 万+ 张够用;
要跑开源 LLM?vLLM 教程直接免费跑完;
要榨干?A10 上批量投喂、Volume 缓存、短 idle 窗口,三件套吃满 $30。
那 $30 不是天上掉馅饼的"免费午餐",而是一张"云上 GPU 体验券"——用得懂机制的人能换出几千张图、几千万 token;用不懂的人可能跑了几次就超额或闲置清零。区别在于:你有没有把任务排进同一个热容器里。