Markdown:从博客作者的偷懒工具,到 AI 时代的“隐形水管”
一、2004 年,一个博主忍不了了
故事的主角叫 John Gruber,美国博客作者。那是 2004 年,博客的黄金年代。写博客的人每天要面对一件让人生无可恋的事:写 HTML。
你想让一个词加粗,得写 <strong>重要</strong>;想列三条,得套一堆 <ul><li>。写三百字,一百五十字是尖括号。就像给朋友写封信,每写一个字都要先在字外面画个框,注明“这是字”。
Gruber 忍不了了。但他要解决的问题很微妙:不是彻底干掉 HTML,而是让机器能看懂、人看着又不像被机器加工过。
他做了一件聪明的事——没有发明语法,而是去“追认”语法。
在 1990 年代的电子邮件和论坛里,人们早就自发形成了一套土办法:想强调一个词,两边加星号写成 *重要*;想画分割线,敲一排减号;想列清单,前面点个减号。没人规定过,但所有人都这么干,也都看得懂。
Gruber 干的事,是把这套流传了十几年的民间习惯整理成规范,再写个脚本把它翻译成 HTML。给他大量意见的,还有一个当时只有十七岁的少年——Aaron Swartz,后来参与创建 Reddit、起草 RSS 规范的那位。
2004 年 3 月,Markdown 正式发布。它的输出目标从第一天起就是 HTML。它压根不是 HTML 的敌人,而是 HTML 的“前台接待”:你用大白话说事,它翻到后厨变成一串尖括号。
二十多年后,一群人跳出来说“应该抛弃 Markdown、改用 HTML”——这话听着像什么?像有人郑重宣布:我们应该抛弃点菜,改用炒菜。
二、为什么 AI 突然“爱吃”它
AI 来了之后,大家惊奇地发现:这帮模型对 Markdown 极其熟悉。你给它一段,它读得又快又准;你不加限制,它自己吐出来的也是 Markdown。于是“Markdown 是 AI 的母语”开始流行。
观察没错,但原因和大多数人想的完全不一样。真实原因有三条:
第一,泡大的,不是教的。 大模型训练语料里塞满了 GitHub 上几千万份 README、技术文档、Stack Overflow 问答、Reddit 帖子——这些东西,绝大部分是 Markdown。模型不是被精心设计去学 Markdown 的,纯粹是因为互联网上讲道理的文本,大部分长这样。就像你从小听粤语歌长大,不是“学会”了粤语,是“泡”进去的。
第二,按 token 收费,它就是便宜。 大模型按 token 算钱。同样加粗“苹果”两个字,HTML 写法 <strong>苹果</strong> 约 12 个 token,Markdown 写法 **苹果** 约 4 个 token,差三倍。把同一份内容清洗成干净的 Markdown 再喂给模型,普遍能省下两三成 token。上下文窗口就那么大,省下来的每一寸都能装真正有用的内容。
第三,歧义小。 同一个“三级标题”,HTML 有几十种写法:<h3>、带 class 的 <div>、一堆 <span> 硬凑……人眼看着一样,模型读到的是三种不同结构。Markdown 只有一种写法:###。模型走在上面不容易迷路,也就不容易乱编。
三、争论的两面
基于这三条,网上分成了两派。
一派说:普通人必须学。 这类文章通常长这样——先告诉你 Word 的二进制格式锁死在软件里,而 Markdown 是纯文本,五十年后记事本还能打开;再说 AI 生成的默认就是 Markdown,你不懂就得在 Word 里重新调那一坨乱掉的缩进;最后甩一张语法表:# 是标题、** 是加粗、- 是列表、> 是引用。结论往往是:花二三十分钟习惯一下,你就拥有了 AI 时代的“万能通行证”。
另一派说:不用专门学,它是模型之间的通用语。 开头那篇微信文章的论点就在这:模型输出 Markdown,是因为聊天框会把它渲染成漂亮排版,这是产品侧的选择,是“客随主便”,不是模型在向你索要暗号。真正让模型答得好的,从来不是那几个井号,而是井号背后你想没想清楚。一个人脑子里一团浆糊,写出来的 Markdown 也是一团结构精美的浆糊。
这两派其实都没全错,只是看的是管道的不同位置。
四、HTML 的反攻,和“三段管道”
今年(2026 年)五月,争论升级了。Anthropic 旗下 Claude Code 的工程负责人 Thariq Shihipar 发了一篇长文,说自己在日常工作中已经彻底不用 Markdown 承载 AI 的产出,改用语法的 HTML。几乎同时,前 OpenAI 研究总监 Andrej Karpathy 也公开建议:让大模型把回答输出成 HTML,在浏览器里看。
网上立刻炸了:“Markdown 要完蛋了!”
冷静下来看,他们吵的压根不是“模型读什么”,而是“人看什么”。Markdown 渲染出来永远是那副样子——一条黑白的长面条。它做不了多栏对比,做不了折叠,做不了图表,做不了交互。更要命的是分享:Markdown 文件得有渲染器才能看,HTML 双击就能开,甚至能直接甩个链接给领导。
这是“最后一公里”的问题。
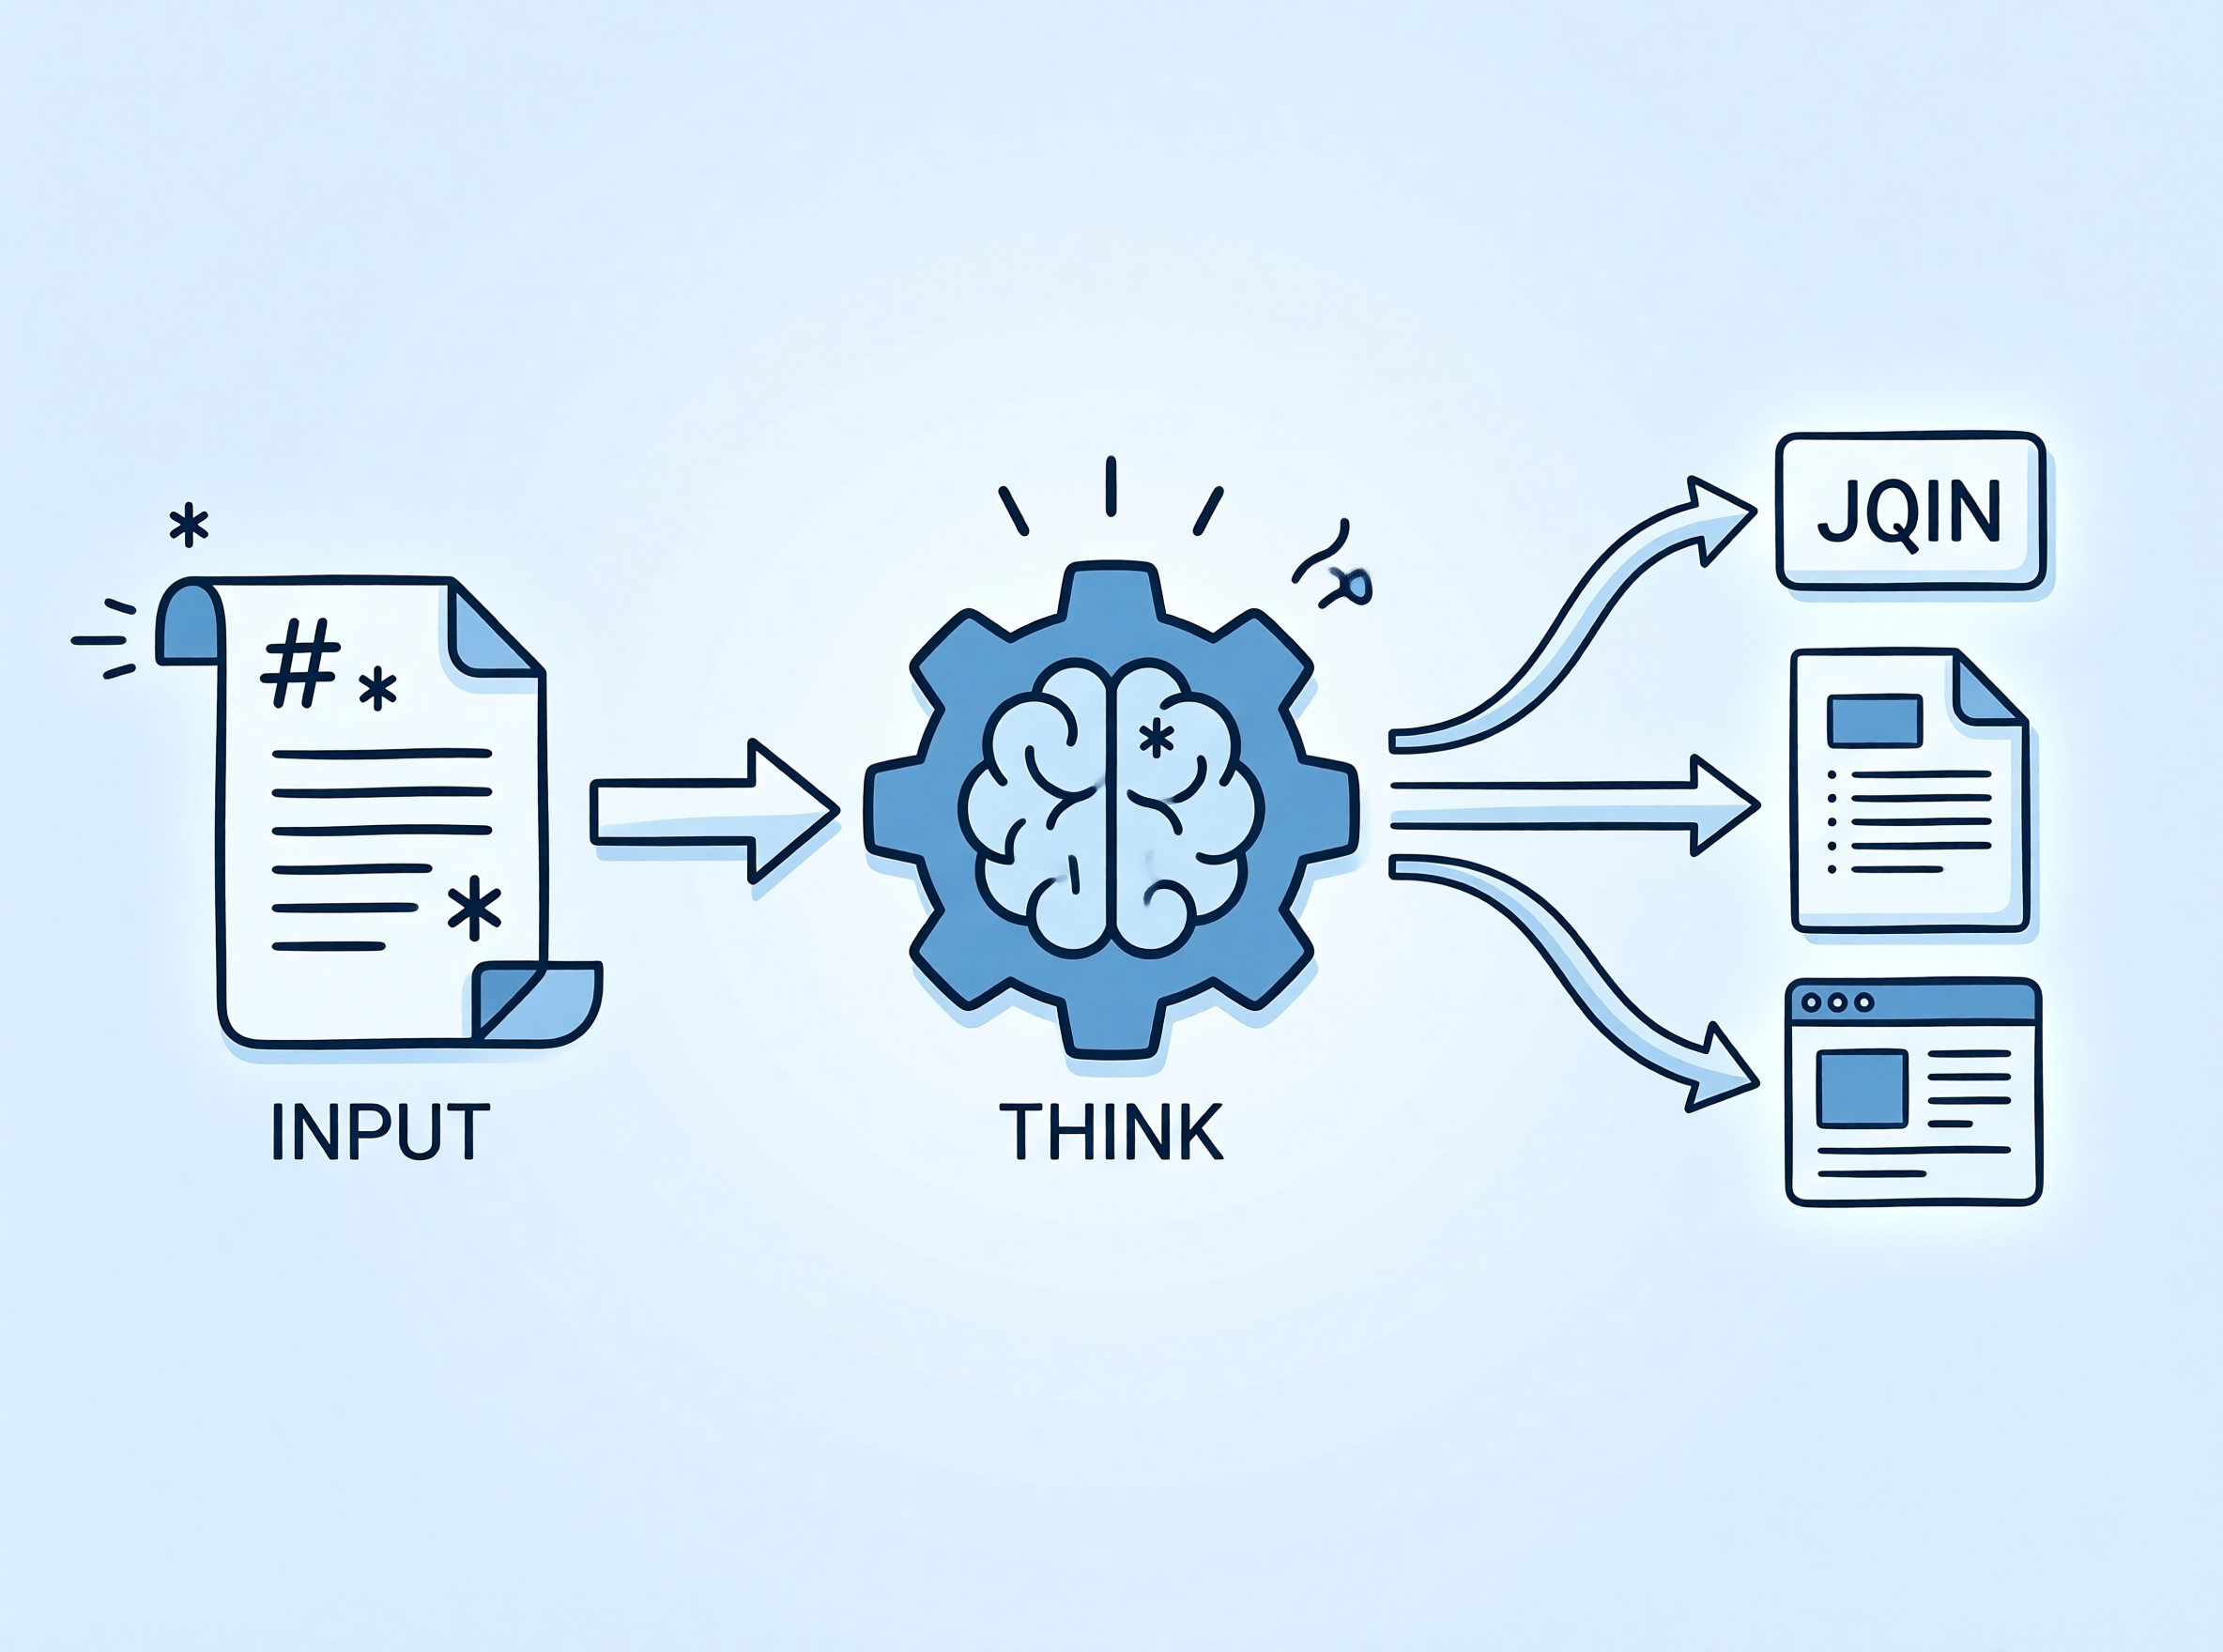
把整条信息链路拆开,一切就清楚了。任何一个 AI 应用,内容都要走三段路:
- 输入:喂给模型的资料 → 最佳格式是 Markdown,省 token、歧义小。把网页、PDF、Word 统统清洗成干净 Markdown 再入库,是 RAG 系统的标准动作。
- 思考:模型内部推理 → 格式无关,模型理解的是语义,不是符号。你把提示词从纯文本改成 Markdown,通常换不来质变;把含混的要求改清楚,才会。
- 输出:呈现给人或系统 → 看目的地。给下一个程序处理用 JSON,存档/进版本管理/再喂给下一轮模型用 Markdown,给人看、一次性交付、分享用 HTML。
所以 Markdown 和 HTML 从来不是二选一,它们只是站在管道的不同位置。更何况别忘了 Markdown 的老底——它的终点本来就是 HTML。
五、一条还在往前走的时间线
Markdown 这二十多年,不是静止的:
- 2004 年:John Gruber 发布 Markdown 1.0,Aaron Swartz 参与设计,Perl 脚本把纯文本翻成 HTML。
- 2004–2014 年:由于 Gruber 的原始描述有歧义,各种实现(GitHub、Reddit、Stack Overflow、Pandoc……)各自加料,同一份文档在不同平台渲染出不同样子。Gruber 本人甚至认为“完全标准化是个错误,不同站点有不同需求”。
- 2014 年:Jeff Atwood、John MacFarlane 等人发起标准化,最初叫“Standard Markdown”,Gruber 反对在名称里用“Markdown”,遂改名 CommonMark——一份无歧义的规范加测试套件。
- 2016 年:IETF 发布 RFC 7764,正式讨论并注册了 CommonMark、GitHub Flavored Markdown、Pandoc、MultiMarkdown 等多种变体。
- 2017 年:GitHub 发布 GFM(GitHub Flavored Markdown) 正式规范,基于 CommonMark,补齐了表格、删除线、任务列表等扩展。
- 2026 年:Claude Code 团队公开把 HTML 作为复杂产出(规格书、代码审查、设计原型)的默认格式,引发“Markdown 是否已死”的大讨论。
有意思的是,这场争论本身恰恰证明了 Markdown 的胜利——它好用到成了默认,才有人来讨论“什么时候该换掉它”。
六、落到实处:你该怎么做
把上面的长篇大论收成一个务实的建议:
知道它是什么,会用最常见的五六个符号,然后就把它忘掉。
#标题、**加粗、-列表、>引用、[文字](链接)链接、\\`\`代码块\`\`\`` 代码。二十分钟够了。- 给 AI 的资料,能先变成干净 Markdown 就先变(省 token、准)。
- 要交付给人看的成品,让它输出 HTML 或直接用工具渲染,别发一坨
.md让人自己找渲染器。 - 你脑子里想没想清楚,比用不用 Markdown 重要一万倍。
二十二年前,John Gruber 想解决的只有一个问题:让人写东西的时候,别老想着尖括号。二十二年后,我们和大模型打交道,要解决的其实还是同一个——让人说事的时候,别老想着格式。
技术应该去迁就人,而不是让人去迁就技术。Markdown 最深刻的那条哲学,从头到尾没变过。
参考资料:微信文章《Markdown 是不是 AI 时代的通用语》、人人都是产品经理《一个“设计失败”的格式,凭什么成了 AI 的母语》、Claude Code 团队《The Unreasonable Effectiveness of HTML》、CommonMark 规范与 RFC 7764。